Що таке embeddings простими словами
Як текст перетворюється на список чисел, що вміє «розуміти» сенс — основа семантичного пошуку та RAG.
Fullstack Team· 23 липня 2026 р.
AI
Embeddings — це числа зі змістом
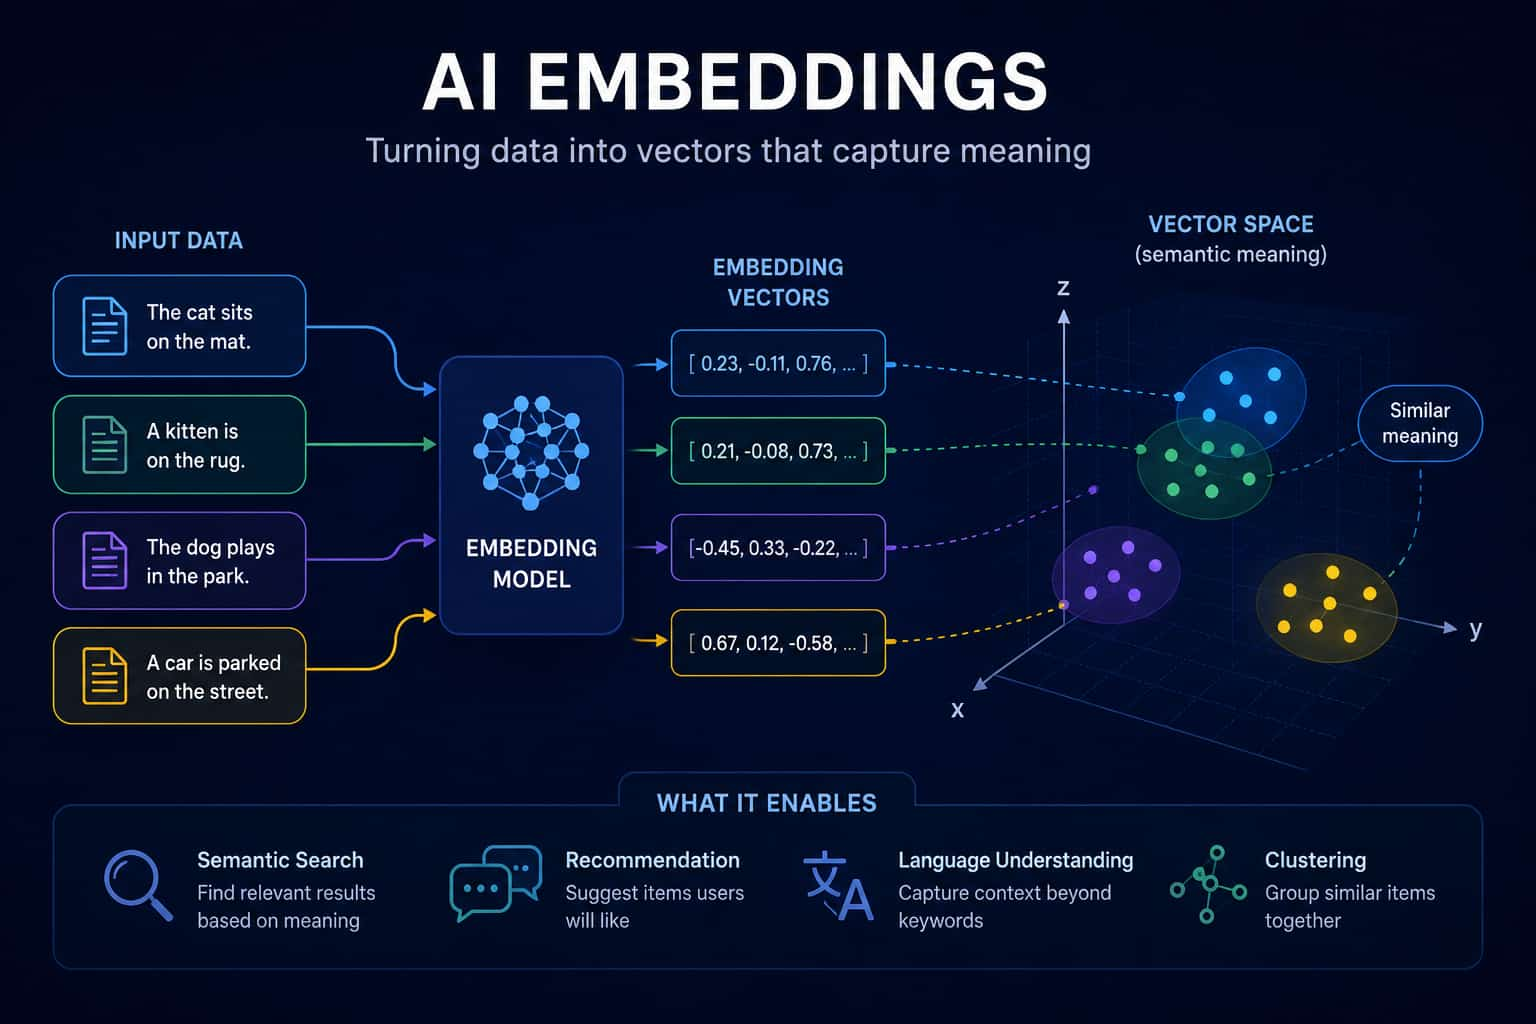
Embedding — це числове представлення об’єкта: тексту, зображення, аудіо або іншого типу даних.
Для тексту embedding — це список чисел, наприклад:
text
[0.12, -0.48, 0.73, 0.05, ...]Такий список називають вектором. У ньому може бути сотні або тисячі чисел.
На перший погляд це просто набір значень. Але спеціально навчена модель перетворює схожі за змістом тексти на схожі вектори.
Наприклад, ці речення мають близький сенс:
Як змінити пароль?Я хочу оновити свій парольДе в налаштуваннях змінюється пароль?
Їхні embeddings будуть розташовані близько один до одного у математичному просторі.
Натомість речення:
Як приготувати борщ?
матиме значно віддаленіший вектор.
Саме це дозволяє програмам працювати не лише зі збігами слів, а й зі схожістю значення.
Чим embedding відрізняється від звичайного пошуку
Звичайний пошук часто шукає однакові слова.
Якщо користувач вводить:
text
Як відновити доступ?пошукова система може шукати саме слова відновити та доступ.
Але в документації потрібна інформація може бути сформульована інакше:
text
Інструкція зі скидання пароля користувачаУ цих фразах немає повного збігу слів, але їхній зміст схожий. Семантичний пошук за embeddings може це виявити.
Порівняймо:
Пошук за ключовими словами: чи збігаються слова?
Семантичний пошук: чи схожий зміст?
Embedding допомагає перейти від пошуку символів до пошуку сенсу.
Як текст перетворюється на вектор
Процес зазвичай має такий вигляд:
Текст передається embedding-моделі.
Модель аналізує слова та їхній контекст.
Модель обчислює числовий вектор фіксованої довжини.
Вектор зберігається або порівнюється з іншими векторами.
Наприклад:
text
"Кіт сидить на дивані"може бути перетворений на:
text
[0.18, -0.04, 0.61, 0.27, ...]Важливо: окремі числа зазвичай не мають зрозумілого для людини значення.
Не можна сказати:
Перше число відповідає за тему, друге — за дію, третє — за тварину.
Сенс кодується розподілено в усьому векторі. Значення має не окреме число, а положення вектора відносно інших векторів.
Простір embeddings
Уявімо карту, на якій кожен текст — це точка.
Тексти про програмування утворюють одну область:
Як працює JavaScript?Що таке змінна в Python?Як створити REST API?
Тексти про кулінарію будуть в іншій області:
Як зварити пасту?Рецепт яблучного пирогаСкільки часу пекти хліб?
Реальні embeddings мають не два або три виміри, а значно більше. Людина не може безпосередньо уявити простір із сотнями вимірів, але математичні операції в ньому працюють.
Чим ближче точки одна до одної, тим більш схожими вважаються відповідні тексти.
Як вимірюють схожість
Для порівняння embeddings використовують функції схожості або відстані.
Найпоширеніший варіант — косинусна схожість.
Вона вимірює кут між двома векторами:
значення, близьке до
1, означає високу схожість;значення, близьке до
0, означає слабкий зв’язок;від’ємне значення може вказувати на протилежний напрямок.
Спрощена реалізація виглядає так:
python
import math


def cosine_similarity(first, second):
    # Перевіряємо, що вектори мають однакову довжину
    if len(first) != len(second):
        raise ValueError("Вектори повинні мати однакову довжину")

    dot_product = sum(a * b for a, b in zip(first, second))
    first_length = math.sqrt(sum(value * value for value in first))
    second_length = math.sqrt(sum(value * value for value in second))

    if first_length == 0 or second_length == 0:
        raise ValueError("Нульовий вектор неможливо порівняти")

    return dot_product / (first_length * second_length)


query = [0.9, 0.8, 0.1]
document = [0.8, 0.7, 0.2]

similarity = cosine_similarity(query, document)

print(similarity)
У реальному застосунку самі вектори генерує embedding-модель. Функція схожості лише порівнює вже готові результати.
Приклад семантичного пошуку
Припустімо, у нас є база документів:
Інструкція зі скидання пароляПравила повернення товаруНалаштування двофакторної автентифікаціїСпособи оплати замовлення
Користувач вводить:
text
Я не можу увійти до свого облікового записуПошукова система:
створює embedding для запиту;
створює embeddings для документів;
порівнює вектор запиту з векторами документів;
сортує документи за схожістю;
повертає найбільш релевантні результати.
Найкращим результатом може стати документ про скидання пароля, навіть якщо в запиті не було слова пароль.
Спрощено логіку можна описати так:
python
documents = [
    {
        "text": "Інструкція зі скидання пароля",
        "embedding": [0.91, 0.72, 0.18],
    },
    {
        "text": "Правила повернення товару",
        "embedding": [0.12, 0.21, 0.88],
    },
    {
        "text": "Налаштування двофакторної автентифікації",
        "embedding": [0.83, 0.69, 0.25],
    },
]

query_embedding = [0.88, 0.70, 0.20]

ranked_documents = sorted(
    documents,
    key=lambda document: cosine_similarity(
        query_embedding,
        document["embedding"],
    ),
    reverse=True,
)

for document in ranked_documents:
    print(document["text"])
У цьому прикладі embeddings задані вручну лише для демонстрації. У справжній системі їх генерує модель.
Що таке RAG
RAG, або Retrieval-Augmented Generation, — це підхід, у якому мовна модель спочатку отримує релевантну інформацію з зовнішнього джерела, а потім формує відповідь на її основі.
Українською це можна описати як генерацію з доповненням контекстом.
Типовий RAG-процес:
Документи розбивають на фрагменти.
Для кожного фрагмента створюють embedding.
Embeddings зберігають у векторному сховищі.
Користувач ставить запит.
Для запиту створюють embedding.
Система знаходить найближчі фрагменти.
Знайдений текст передають мовній моделі як контекст.
Модель формує відповідь.
Наприклад, компанія має внутрішню документацію. Користувач запитує:
text
Скільки днів можна працювати з дому?Система знаходить у документації фрагмент із політикою віддаленої роботи та передає його мовній моделі. Модель відповідає, спираючись на цей фрагмент, а не лише на загальні знання.
Embeddings у RAG відповідають переважно за етап пошуку контексту.
Чому документи розбивають на фрагменти
Embedding для дуже великого документа може бути недостатньо точним для конкретного запиту.
Уявімо один файл із розділами про:
відпустки;
зарплату;
лікарняні;
безпеку;
віддалену роботу.
Якщо перетворити весь файл на один вектор, він представлятиме одразу багато тем. Пошук конкретного правила може стати гіршим.
Тому документи зазвичай ділять на менші частини — chunks.
Фрагмент може містити:
кілька абзаців;
один розділ;
один пункт інструкції;
логічно завершений блок тексту.
Після цього embedding створюють для кожного фрагмента окремо.
Важливо не розбивати текст механічно посередині важливої думки. Межі фрагментів мають зберігати контекст, а іноді сусідні фрагменти частково перекриваються.
Де використовують embeddings
Семантичний пошук
Пошук знаходить документи за змістом, навіть якщо формулювання запиту й документа різні.
Рекомендації
Можна порівнювати embedding опису товару, статті або фільму з embedding уподобань користувача.
Класифікація
Текст можна перетворити на вектор, а потім визначити його категорію:
технічна підтримка;
оплата;
доставка;
скарга;
запит на повернення.
Пошук дублікатів
Якщо два повідомлення мають дуже близькі embeddings, вони можуть бути перефразуваннями одного питання.
Групування текстів
Embeddings допомагають автоматично знаходити тематичні групи без наперед заданих ключових слів.
Виявлення схожих документів
Можна знайти статті, інструкції або записи, що мають близький зміст.
Embedding і токени — не одне й те саме
Ці поняття часто плутають.
Токенізація розбиває текст на частини, з якими працює мовна модель. Токеном може бути слово, частина слова, знак пунктуації або інша послідовність символів.
Embedding перетворює текст або його частину на вектор чисел, який можна порівнювати з іншими векторами.
Спрощена послідовність може бути такою:
text
Текст → токенізація → обробка моделлю → embeddingТокени є внутрішнім поданням тексту для моделі, а embedding — зручним числовим поданням для пошуку та порівняння.
Embedding і генеративна модель — різні речі
Embedding-модель і мовна генеративна модель виконують різні завдання.
Embedding-модель
Створює вектор для тексту. Її результат можна використовувати для:
пошуку;
порівняння;
кластеризації;
рекомендацій.
Генеративна модель
Створює новий текст: відповідь, пояснення, резюме або код.
У RAG ці моделі часто працюють разом:
embedding-модель знаходить потрібний контекст;
генеративна модель читає контекст і створює відповідь.
Обмеження embeddings
Embeddings не є універсальним «розумінням» тексту.
Можлива втрата деталей
Два тексти можуть бути загалом схожими, але мати важливу відмінність:
Повернення можливе протягом 14 днівПовернення можливе протягом 30 днів
Їхні embeddings можуть бути близькими, хоча числа змінюють зміст правила.
Тому для критично важливих відповідей потрібно перевіряти знайдений текст, а не покладатися лише на оцінку схожості.
Схожість не гарантує правильність
Вектор може бути близьким через загальну тему, але документ не обов’язково міститиме відповідь на запит.
Наприклад, документи про платежі можуть бути схожими, хоча один описує оплату карткою, а інший — повернення коштів.
Залежність від моделі
Різні embedding-моделі можуть по-різному оцінювати ті самі тексти. Вектори, створені однією моделлю, зазвичай не слід безпосередньо порівнювати з векторами іншої.
Якщо модель змінюється, часто потрібно повторно створити embeddings для всієї колекції документів.
Мовні особливості
Якість залежить від того, наскільки добре модель працює з конкретною мовою, термінологією та стилем тексту.
Для українських текстів варто перевіряти якість на власних прикладах, особливо якщо в документах є:
вузькопрофільна термінологія;
скорочення;
назви внутрішніх систем;
змішування української та англійської мов.
Конфіденційність
Текст, який передають зовнішньому сервісу для створення embedding, може містити персональні або корпоративні дані.
Перед використанням потрібно визначити:
де обробляються дані;
як довго вони зберігаються;
чи можна передавати конфіденційний текст;
чи потрібно анонімізувати дані.
Поширені помилки
Плутати embeddings із перекладом
Embedding не перекладає текст і не повертає короткий опис. Це числове представлення, призначене для порівняння та інших обчислень.
Порівнювати вектори різних моделей
Вектори мають сенс у просторі конкретної моделі. Не варто порівнювати embedding запиту, створений однією моделлю, з embedding документа, створеним іншою.
Використовувати лише один великий embedding для всієї бази
Великий документ може містити багато різних тем. Краще розбити його на логічні фрагменти та індексувати їх окремо.
Вважати найвищу схожість правильною відповіддю
Найближчий фрагмент — це лише кандидат на релевантний контекст. Потрібно перевіряти результати на реальних запитах.
Ігнорувати метадані
Іноді одного семантичного пошуку недостатньо. Корисно враховувати додаткові властивості:
мову;
тип документа;
дату;
автора;
доступність для конкретного користувача;
категорію.
Наприклад, пошук політики компанії має повертати актуальний документ, а не стару версію з подібним змістом.
Не перевіряти якість на власних даних
Тестові приклади мають відображати реальні запити користувачів. Варто перевіряти:
чи знаходиться потрібний документ;
на якій позиції він з’являється;
чи не плутаються схожі теми;
як система працює з короткими запитами;
як вона обробляє українські та змішані тексти.
Короткий підсумок
Embedding — це числовий вектор, який представляє зміст тексту.
Схожі за сенсом тексти зазвичай мають близькі вектори.
Для порівняння часто використовують косинусну схожість.
Embeddings лежать в основі семантичного пошуку, рекомендацій, класифікації та пошуку дублікатів.
У RAG embeddings допомагають знайти релевантні фрагменти документів для мовної моделі.
Embeddings не гарантують правильності й не замінюють перевірку джерел.
Якість залежить від embedding-моделі, розбиття документів, метаданих і тестових даних.
Найпростіша інтуїція така: embedding перетворює текст на координати у просторі значень. А пошук за embeddings знаходить не обов’язково ті самі слова, а тексти, що опинилися поруч за змістом.